
Blog
Un assistant documentaire IA pour trois sociétés : architecture et garde-fous
Mise à jour, septembre 2026. Le kit décrit dans cet article est passé en version 2 : l'installation tient désormais en une seule phrase à coller dans votre assistant, sans rien télécharger, et l'assistant s'adapte à votre situation, quelle que soit votre activité. Le parcours complet a été rejoué plusieurs fois de bout en bout sur un corpus de test, avec Claude Code puis avec Codex. Tout est expliqué pas à pas en fin d'article.
Nous avons d'abord construit cet assistant pour nous-mêmes : le groupe compte trois structures, une société de conseil, une holding et une société immobilière familiale, et son service administratif tient en une personne, le soir, après les journées de mission.
Ce retour d'expérience décrit le système que nous avons mis en place pour confier la gestion documentaire de ces trois entités à un assistant IA. Pas un prototype : un système en production, avec ses chiffres et ses limites.
Le problème
Trois entités, c'est trois fonds documentaires. Factures, contrats, statuts, déclarations, relevés, attestations. Des années d'accumulation dans un cloud qui déborde, des doublons partout, des fichiers nommés « document(3).pdf », et un expert-comptable qui attend ses pièces à chaque clôture.
Le classement manuel est la tâche que tout dirigeant repousse. Nous avons arrêté de la repousser le jour où nous avons accepté une évidence : ce travail est exactement ce qu'une IA fait bien, à condition de l'encadrer sérieusement.
Le stock au départ : plus de 3 000 documents à lire, qualifier, renommer et classer.
Les règles avant l'IA
La tentation, c'est de donner l'accès au dossier et de dire « range ». C'est la meilleure façon de transformer un désordre en catastrophe : un modèle de langage sans cadre supprime, écrase et invente.
Nous avons donc posé les règles avant la première action. Les principales :
- Interdiction de supprimer définitivement. Tout passe par la corbeille, réversible.
- Interdiction de modifier ou d'écraser un document original.
- Toute opération massive est précédée d'un plan d'action, validé par un humain.
- Chaque action est journalisée dans un fichier dédié. Des mois après, nous pouvons retracer qui a déplacé quoi, et pourquoi.
- Un doublon n'est déclaré doublon que si son empreinte SHA-256 (la signature unique d'un fichier) est identique à celle d'un original conservé. Jamais sur la foi du nom.
- Chaque document est lu avant d'être classé. Le nom de fichier n'est qu'un indice : un scan nommé « document(3).pdf » peut être un bail commercial.
- Un document au classement incertain part dans un dossier
a_valider, accompagné d'un fichier texte qui explique le doute. L'humain tranche. - Interdiction d'inventer une information absente des documents. L'assistant distingue explicitement les faits confirmés, les hypothèses et ce qui doit être validé par un professionnel. Il ne remplace ni l'expert-comptable ni l'avocat.
Ces règles ne sont pas de la prudence décorative. Chacune correspond à un incident que nous avons vu, ou évité de justesse, sur des systèmes critiques : la suppression irréversible, l'écrasement silencieux, le doublon supprimé qui était en réalité la seule copie signée.
L'architecture index-first
Le vrai verrou technique d'un assistant documentaire, ce n'est pas la lecture des documents. C'est le coût de la relecture.
Si le modèle doit relire les documents à chaque question, le système est lent, coûteux en tokens, et il s'effondre au-delà de quelques centaines de fichiers. La réponse tient en un principe : chaque document est lu une seule fois.
Le pipeline :
- Nous déposons les nouveaux documents dans un dossier
a_trier. - L'assistant lit le contenu réel de chaque fichier et le qualifie : société, année, type, émetteur, objet, niveau de confiance.
- Le fichier est renommé selon une convention unique,
AAAA-MM-JJ_type_tiers_objet.ext, puis classé dans l'arborescence de la bonne société. - Tout est enregistré dans une base SQLite locale : résumé, mots-clés, empreinte SHA-256, avec indexation plein texte (FTS5).
Ensuite, chaque recherche interroge l'index, en quelques secondes. « Retrouve l'attestation d'assurance 2024 » devient une requête sur la base, plus jamais une relecture de PDF. Et le scan est incrémental : grâce aux empreintes, seuls les fichiers nouveaux ou modifiés sont lus.
C'est le principe des moteurs de recherche d'entreprise, ramené à sa plus simple expression : un fichier SQLite de quelques mégaoctets, sans serveur, sans abonnement, qui vit à côté des documents.
Un détail d'installation qui n'en est pas un : l'assistant travaille à la racine d'un dossier unique qui contient toutes vos structures, une société = un dossier. C'est cette vue d'ensemble qui lui permet de router chaque document vers la bonne société et de tenir un index unique. Ne l'ouvrez jamais dans le dossier d'une seule société : il ne verrait qu'elle.
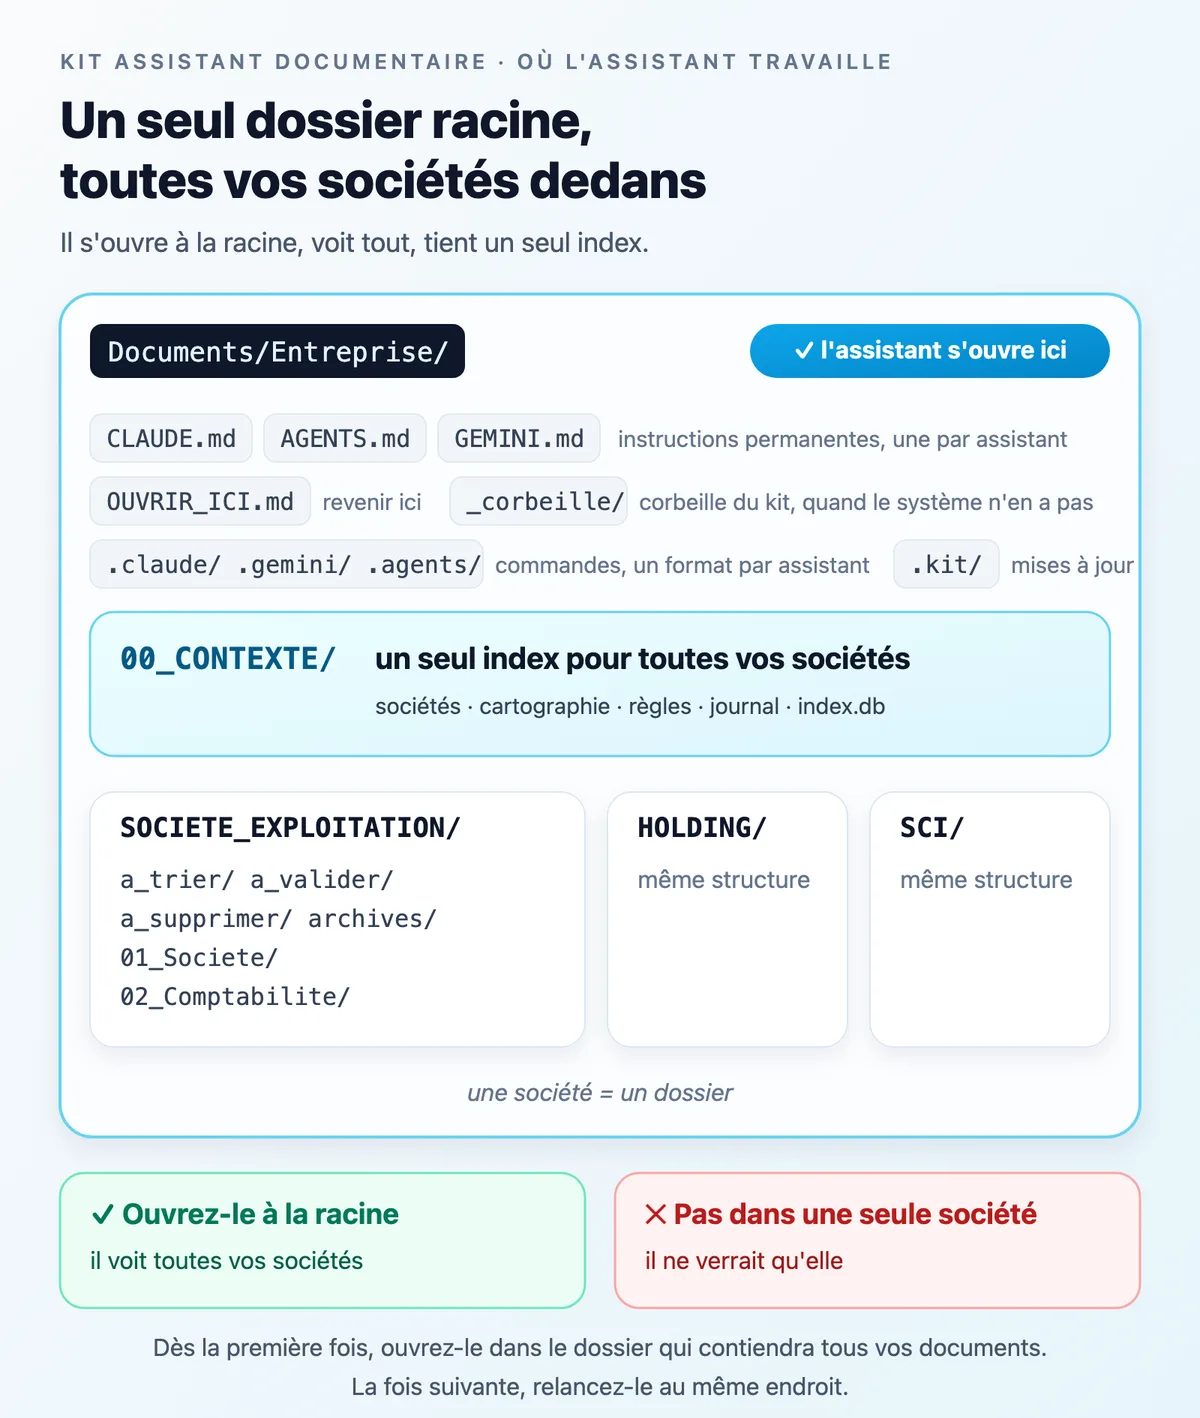 Un seul dossier racine, toutes les sociétés dedans : l'assistant s'ouvre à la racine et tient un seul index.
Voici ce que l'installation crée, celle que nous utilisons, noms de sociétés mis à part :
Documents/Entreprise/         l'assistant s'ouvre ici, à la racine, à chaque session
  CLAUDE.md                   ses instructions permanentes
  AGENTS.md  GEMINI.md        même contenu, pour les autres assistants
  OUVRIR_ICI.md               comment rouvrir l'assistant au bon endroit
  00_CONTEXTE/                sociétés, cartographie, règles, sécurité, journal, passation, commandes, scripts, index
  _corbeille/                 la corbeille du kit, quand celle du système n'est pas accessible ; vous la videz vous-même
  .claude/  .gemini/  .agents/   les mêmes commandes pour Claude Code, Gemini CLI et Codex
  .kit/                       le kit de référence, pour les mises à jour
  SOCIETE_EXPLOITATION/       une société = un dossier
    a_trier/  a_valider/  a_supprimer/  archives/
    01_Societe/
    02_Comptabilite/
  HOLDING/                    même structure
  SCI/                        même structure
Une seule structure ? Même principe, avec un seul dossier de société. Le détail de chaque société (par année, par mois, par type) est proposé plus tard, d'après vos documents réels, pas d'après un modèle.
Les résultats
Les chiffres du dernier inventaire, en juillet 2026 :
- 3 116 fichiers actifs sur les trois sociétés, chacun lu et qualifié par l'assistant, jamais par une règle sur le nom
- réconciliation complète entre le disque et la base : zéro document manquant, zéro fantôme, zéro doublon résiduel
- les zones de tri sont vides : tout ce qui entre est traité au fil de l'eau
Ce que ça change au quotidien : retrouver une pièce est devenu une question posée en langage courant, plus une fouille de vingt minutes. Les documents demandés par l'expert-comptable partent sans relance. Les doublons ont été éliminés avec preuve à l'appui.
Les limites, pour être complet : la mise en place demande de la rigueur, et les premières sessions se font en supervision rapprochée. Certains documents exigent toujours un arbitrage humain, et c'est voulu : le dossier a_valider n'est pas un échec du système, c'est son garde-fou. Enfin, ce système classe et retrouve ; il ne tient pas votre comptabilité et ne remplace aucun conseil professionnel.
Un dernier point à anticiper : le tout premier passage sur l'historique est le moment coûteux. Chaque document est lu une fois, et sur des années d'archives, cela consomme du temps et une bonne part du quota de votre abonnement. C'est normal, et cela n'arrive qu'une fois : traitez l'historique par lots, sur plusieurs sessions. Ensuite, le scan incrémental ne lit que les nouveautés, et le coût devient marginal. Vous payez la lecture une fois ; vous interrogez l'index pour presque rien, indéfiniment.
Deux extensions au-delà du classement
Une fois le fonds documentaire indexé, deux usages se sont imposés naturellement.
Le rapprochement bancaire. Notre banque (Qonto) expose une API, une interface qui permet d'interroger le compte depuis un logiciel. L'assistant y accède en lecture seule et rapproche chaque facture de sa transaction bancaire, par identifiant. Les factures de vente sont ainsi classées au mois du paiement réel, pas au mois d'émission. La règle de sécurité est la même que pour les documents, en plus stricte : lecture seule par défaut, aucune écriture et aucun virement, jamais. Un agent IA n'a rien à faire du côté des ordres bancaires.
La relecture du bilan. Nous avons fourni à l'assistant le bilan préparé par le cabinet comptable, en lui demandant de le confronter aux pièces indexées. Il y a trouvé des erreurs, que le cabinet a corrigées après vérification. Aucune défiance là-dedans : c'est un second regard systématique, qui a l'avantage d'avoir toutes les pièces sous la main au moment de la relecture. La validation finale reste humaine, et la responsabilité aussi.
La version 2 : une phrase à coller, et l'assistant fait le reste
La première version du kit demandait de télécharger une archive, de la dézipper, puis de lancer une installation guidée. C'était déjà simple. C'était encore trop : télécharger un fichier ZIP depuis un site qu'on ne connaît pas, quand on n'est pas technicien, c'est précisément le genre de geste qui fait renoncer. La version 2 part d'un principe : vous ne devriez rien avoir à faire de technique, jamais. Alors nous avons tout inversé : ce n'est plus vous qui installez l'outil, c'est l'assistant qui s'installe lui-même, sous vos yeux, en vous demandant la permission à chaque étape.
Voici, concrètement, ce qui se passe. Prenez le temps de lire : c'est aussi une bonne façon de comprendre ce que vous confiez, et ce que vous ne confiez pas, à une IA.
Minute zéro : une phrase, et c'est tout
Vous installez Claude Code (l'application officielle d'Anthropic, comme n'importe quelle application), vous vous connectez avec votre compte, et vous collez cette phrase :
Récupère https://raw.githubusercontent.com/DGUCons/kit-assistant-documentaire/main/START.md et suis ces instructions pas à pas.
C'est la seule chose « technique » que vous ferez. L'assistant va chercher lui-même ses instructions, qui sont des fichiers texte publics : n'importe qui peut les lire, avant même de les utiliser. Pas d'installateur, pas de programme caché, rien à dézipper.
Avant de coller cette phrase, ouvrez votre assistant dans le dossier qui contiendra tous vos documents et la base : par exemple Documents/Entreprise, à créer vide s'il n'existe pas, ou votre dossier principal actuel. Dans l'application de bureau, c'est la puce du dossier, sous la zone de saisie de l'onglet « Code », ou le dossier connecté dans « Cowork » ; dans un terminal, c'est le dossier où vous lancez claude, codex ou gemini. Avec Codex, c'est même indispensable : il ne lit ses instructions que dans le dossier où la session est ouverte. L'assistant confirme ce choix avec vous pendant l'entretien, vous liste ce qu'il créerait, et n'y crée rien avant votre accord. La fois suivante, relancez-le au même endroit, à la racine (voir l'architecture plus haut). Pas besoin de retrouver l'ancienne conversation : une session neuve à la racine suffit, tout est dans la passation, dites « Reprenons ». C'est aussi écrit dans OUVRIR_ICI.md, à la racine. Et si une session s'ouvre par erreur dans un sous-dossier, ses instructions contiennent le chemin de la racine : il s'y replace tout seul.
La toute première chose qu'il fait ensuite n'est pas de fouiller vos dossiers. Il vous demande si c'est une première installation ou une reprise, puis il se présente et vous annonce les règles qu'il s'engage à respecter : il ne supprime jamais rien définitivement, il ne modifie jamais un document original, il note chaque action dans un journal que vous pouvez relire, il ne touche à rien en série sans vous avoir montré un plan, il lit réellement chaque document avant de le classer, il n'écrit jamais sur un système externe (votre banque, si un jour vous la connectez, restera en lecture seule), et il n'ouvre jamais un dossier que vous lui avez interdit. Il vérifie même vos réglages d'assistant existants, pour vous signaler si l'un d'eux entrerait en conflit avec ces règles.
Ce démarrage par les règles n'est pas un détail de communication. C'est la thèse de tout ce projet : on ne juge pas un outil d'IA à ce qu'il fait, mais à ce qu'on l'empêche de faire.
L'entretien : six questions, avec sa recommandation à chaque fois
Vient ensuite un entretien court, six questions et trois validations, une par message, en français courant. Pas un formulaire : une conversation. Et à chaque question, l'assistant vous donne son avis (« Ma recommandation : ... »), que vous êtes libre de suivre ou non.
Il vous demande combien de structures vous gérez : société, activité en nom propre, SCI, même une structure en sommeil. Puis il vous propose quelque chose que la version 1 ne savait pas faire : retrouver lui-même les informations officielles de vos entreprises (numéro SIREN, forme juridique, code d'activité) sur l'annuaire public des entreprises, à partir du simple nom. Et comme il existe des homonymes, il vous montre chaque fiche trouvée, avec la ville et le dirigeant, et attend que vous confirmiez : entre deux « Atelier Perrin », c'est vous qui tranchez, jamais lui. S'il y en a trop pour les montrer, il pose une seule question de rattrapage, « Dans quelle ville se trouve le siège ? », puis cherche à nouveau. Toujours rien ? L'information est notée « à vérifier », jamais inventée.
Il vous demande qui tient votre comptabilité aujourd'hui, et si quelqu'un d'autre la tenait avant : les vieux documents portent souvent le nom de l'ancien cabinet. Puis vos comptes bancaires : la banque, le nom du compte, la société rattachée, et jamais l'IBAN. Plus tard, une fois l'historique lu, il vous proposera des modules optionnels, jamais imposés : la consultation en lecture de sites convenus avec vous (l'espace de votre cabinet, le site des impôts), ou le rapprochement bancaire (chaque facture reliée à son paiement) en lecture seule stricte.
Puis vient la question la plus importante : où vivent vos documents aujourd'hui ? Un dossier sur l'ordinateur, un OneDrive, un Google Drive ? L'assistant recense tout, lieu par lieu. Il ne lit pas les boîtes mail : les pièces jointes importantes, comme les papiers scannés avec le téléphone, se déposent en PDF dans un dossier « à trier ». C'est vous qui lui désignez le dossier : vous le glissez dans la fenêtre, ou vous tapez son chemin. Il ne fouille jamais votre ordinateur de son propre chef ; il ne va que là où vous l'envoyez, et il le dit dès la première minute. Il vous demande aussi, avant d'ouvrir quoi que ce soit, s'il existe des dossiers qu'il ne doit jamais lire : dossier médical, documents personnels. Ceux-là, il ne les ouvrira jamais, et c'est vérifiable dans son journal.
À la fin de l'entretien, il vous relit tout, fiche par fiche, et vous validez. Rien n'a encore été écrit sur votre disque. Sur notre corpus de test, l'assistant le résumait en une ligne : 21 fichiers comptés, aucun ouvert, le dossier « Perso » ignoré.
La lecture de l'historique : honnêteté sur le coût, et rien ne se perd
L'installation proprement dite prend dix minutes : votre dossier documentaire unique est créé à l'endroit choisi ensemble, avec ses règles, son journal, et son index (voyez-le comme un carnet où chaque document aura sa fiche : date, émetteur, montant, résumé). Le premier geste de l'assistant dans ce dossier est un test devant vous : il crée un fichier témoin, le met à la corbeille, et vous demande d'ouvrir votre corbeille pour constater qu'il y est bien, récupérable. Sa première règle, prouvée en trente secondes.
Ensuite commence le gros du travail : lire votre historique. Et là, l'assistant vous dit la vérité avant de commencer, chiffres à l'appui : « vous avez environ tant de documents, cela prendra environ tant de sessions, et cela consommera une bonne partie du quota de votre abonnement ». Le quota, c'est le crédit d'usage de votre abonnement, qui se recharge régulièrement. Lire des années d'archives le consomme vite. C'est le moment coûteux, il est annoncé, et il n'arrive qu'une seule fois : chaque document n'est lu qu'une fois dans sa vie, sa fiche est gardée dans l'index, et ensuite toutes les recherches interrogent l'index, en quelques secondes.
Et si une session s'arrête en plein milieu, quota épuisé, ordinateur fermé, panne d'envie ? Rien ne se perd. L'avancement est enregistré document par document. À la session suivante, vous ouvrez votre assistant et vous dites un seul mot : « Reprenons ». Il vous dit où vous en étiez, et continue. Sur nos trois sociétés, ce mécanisme a tenu sans perdre un seul document.
Et il lit vraiment. Sur notre corpus de test, il l'a signalé de lui-même : « Le nom de fichier ment souvent : EDF mai.pdf n'est pas une facture EDF ; la vraie copie est Facture Lopez (1).pdf. »
Détail qui compte : pendant toute cette phase de lecture, aucun fichier n'est déplacé. L'assistant apprend d'abord, il range ensuite.
Puis les rôles s'inversent : c'est lui qui vous pose les questions
Une fois tout lu, l'assistant fait quelque chose d'assez satisfaisant : il vous apporte la liste de ce que vos documents ne lui ont pas permis de comprendre. « Je vois 47 documents de la SARL Dupont : fournisseur ou client ? » « Je ne trouve presque rien en 2022 : trou réel, ou une source qu'on a oubliée ? » Et il dit ce qu'il n'a pas vu : « Vous m'avez déclaré trois comptes bancaires, je n'ai trouvé que deux relevés, et rien du tout pour la SCI. » Ou encore : « Mon index ne couvre que 2025, je vous le dirai à chaque recherche. » Dix points au plus, dans un seul tableau, avec sa proposition sur chaque ligne, puis une seule question : tout valider d'un coup, ou reprendre point par point. C'est exactement le travail qu'un très bon assistant humain ferait, sauf qu'il l'a fait sur la totalité de vos archives.
Alors seulement, il vous propose un rangement : une arborescence claire, construite d'après vos documents réels (pas un modèle théorique), que vous validez structure par structure. La migration se fait par petits plans d'une cinquantaine de fichiers, chacun présenté avant, validé, vérifié après, et réversible : l'ancien emplacement de chaque fichier est conservé. Les doublons ? Il n'a le droit d'en mettre un à la corbeille que si l'empreinte cryptographique des deux fichiers est rigoureusement identique, la preuve absolue. Un simple « ça ressemble » part dans un dossier de mise de côté, avec une note expliquant pourquoi, et c'est vous qui déciderez.
Votre quotidien, après
Le rythme de croisière tient en une phrase : vous déposez tout nouveau document dans un dossier « à trier », et vous dites /traiter-a-trier. Le reste est fait, journalisé, indexé. Dix commandes sont installées, en français : retrouver n'importe quelle information (« retrouve-moi la facture du plombier de mars »), voir où en est le système, surveiller les échéances repérées dans vos documents (TVA, CFE, assemblée annuelle), préparer un dossier complet pour votre comptable avec la liste des pièces manquantes, vérifier l'intégrité de l'ensemble, ou mettre à jour le kit sans jamais toucher à vos réglages ni à votre index.
Notre mesure préférée reste la même qu'en version 1 : retrouver une pièce pour l'expert-comptable prenait vingt minutes de fouille. Elle prend maintenant le temps de formuler la question.
Et si vous n'utilisez pas Claude ?
La version 2 fonctionne avec six parcours : Claude Code en terminal, l'application Claude (onglets « Code » et « Cowork »), Codex en terminal ou dans l'application ChatGPT, et Gemini CLI. Même entretien, mêmes règles, même résultat sur votre disque. Soyons honnêtes, comme toujours ici : le kit est vérifié de bout en bout avec Claude, qui reste le parcours complet. Le parcours a aussi été rejoué en entier avec Codex, sur le même corpus de test, jusqu'au rangement final. Deux différences pratiques : il faut l'ouvrir à la racine, sans quoi il perd vos règles, et ses questions arrivent sous forme de choix numérotés, auxquels vous répondez par un chiffre. Comptez aussi plus de quota. Avec les autres assistants, l'essentiel fonctionne mais des manques sont possibles, et tout ce qui consulte un site à votre place (l'espace de votre cabinet, le site des impôts) demande Claude. Côté machines : Windows, macOS et Linux.
Ce que ça coûte, et ce que ça vaut
L'abonnement Claude Pro (de l'ordre de 20 dollars par mois hors taxes) suffit pour l'usage courant. Le premier passage sur l'historique est le moment gourmand ; un palier supérieur le premier mois l'accélère, puis vous redescendez. Le kit lui-même est gratuit, open source, sous licence MIT : github.com/DGUCons/kit-assistant-documentaire. Vos documents restent chez vous ; il n'existe aucun serveur du kit ; et si vous arrêtez tout demain, il vous reste une arborescence propre, des noms de fichiers lisibles et un index dans un format standard. Aucun enfermement.
Une faveur, si le kit vous rend service
Laissez-lui une étoile sur GitHub. C'est un clic, gratuit, et c'est ce qui le rend visible pour les autres dirigeants qui cherchent la même solution sans savoir qu'elle existe.
En haut à droite de la page du dépôt, cherchez ce bouton :
Et si vous préférez en parler avant de vous lancer, ou le faire installer sans vous en occuper : notre audit flash gratuit dure 30 minutes en visio, sans engagement. Les autres usages que nous outillons sont sur notre page IA et automatisation.
Une règle pour la route, si vous ne deviez en retenir qu'une : on ne juge pas un outil d'IA à ce qu'il fait, mais à ce qu'on l'empêche de faire.
À lire aussi
- Sauvegardes : les 12 questions à poser à votre prestataire informatique
12 questions sans jargon, classées par criticité, pour vérifier en une semaine si vos sauvegardes vous protègent vraiment, et comment lire les réponses.
- Facturation électronique : ce qui change pour votre PME en septembre 2026
Ce qui change vraiment pour votre PME avec la facturation électronique, le calendrier officiel par taille d'entreprise et les deux appels à passer.
- IA en PME : 5 usages concrets à moins de 50 euros par mois
Cinq usages concrets de l'IA pour une PME, à moins de 50 euros par mois : ce que chacun fait, sa limite et la précaution à prendre sur vos données.
Besoin d'un regard extérieur ?
30 minutes en visio, cinq sujets passés en revue (sauvegardes, accès et MFA, mises à jour, sécurité du poste, continuité d'activité), 3 recommandations écrites envoyées sous 48 h. Sans engagement.
Réserver mon audit flash gratuit